

Deteksi Gender dari Suara Berbasis Deep Learning & MLOps Platform
Platform klasifikasi gender berbasis audio yang mengekstraksi fitur MFCC menggunakan Librosa, melatih model Deep Learning (RNN, LSTM, GRU), dan mengintegrasikan alur kerja MLOps (MLflow, DVC, CI/CD) hingga deployment di Hugging Face Spaces.
Ekstraksi Fitur
MFCC Spectral Audio
Arsitektur Model
RNN, LSTM, GRU
Deployment
Hugging Face Spaces
MLOps Stack
MLflow + DVC + CI/CD
Hasil Nyata & Tampilan Sistem
Tangkapan layar hasil produksi atau prototipe sistem yang dibangun.
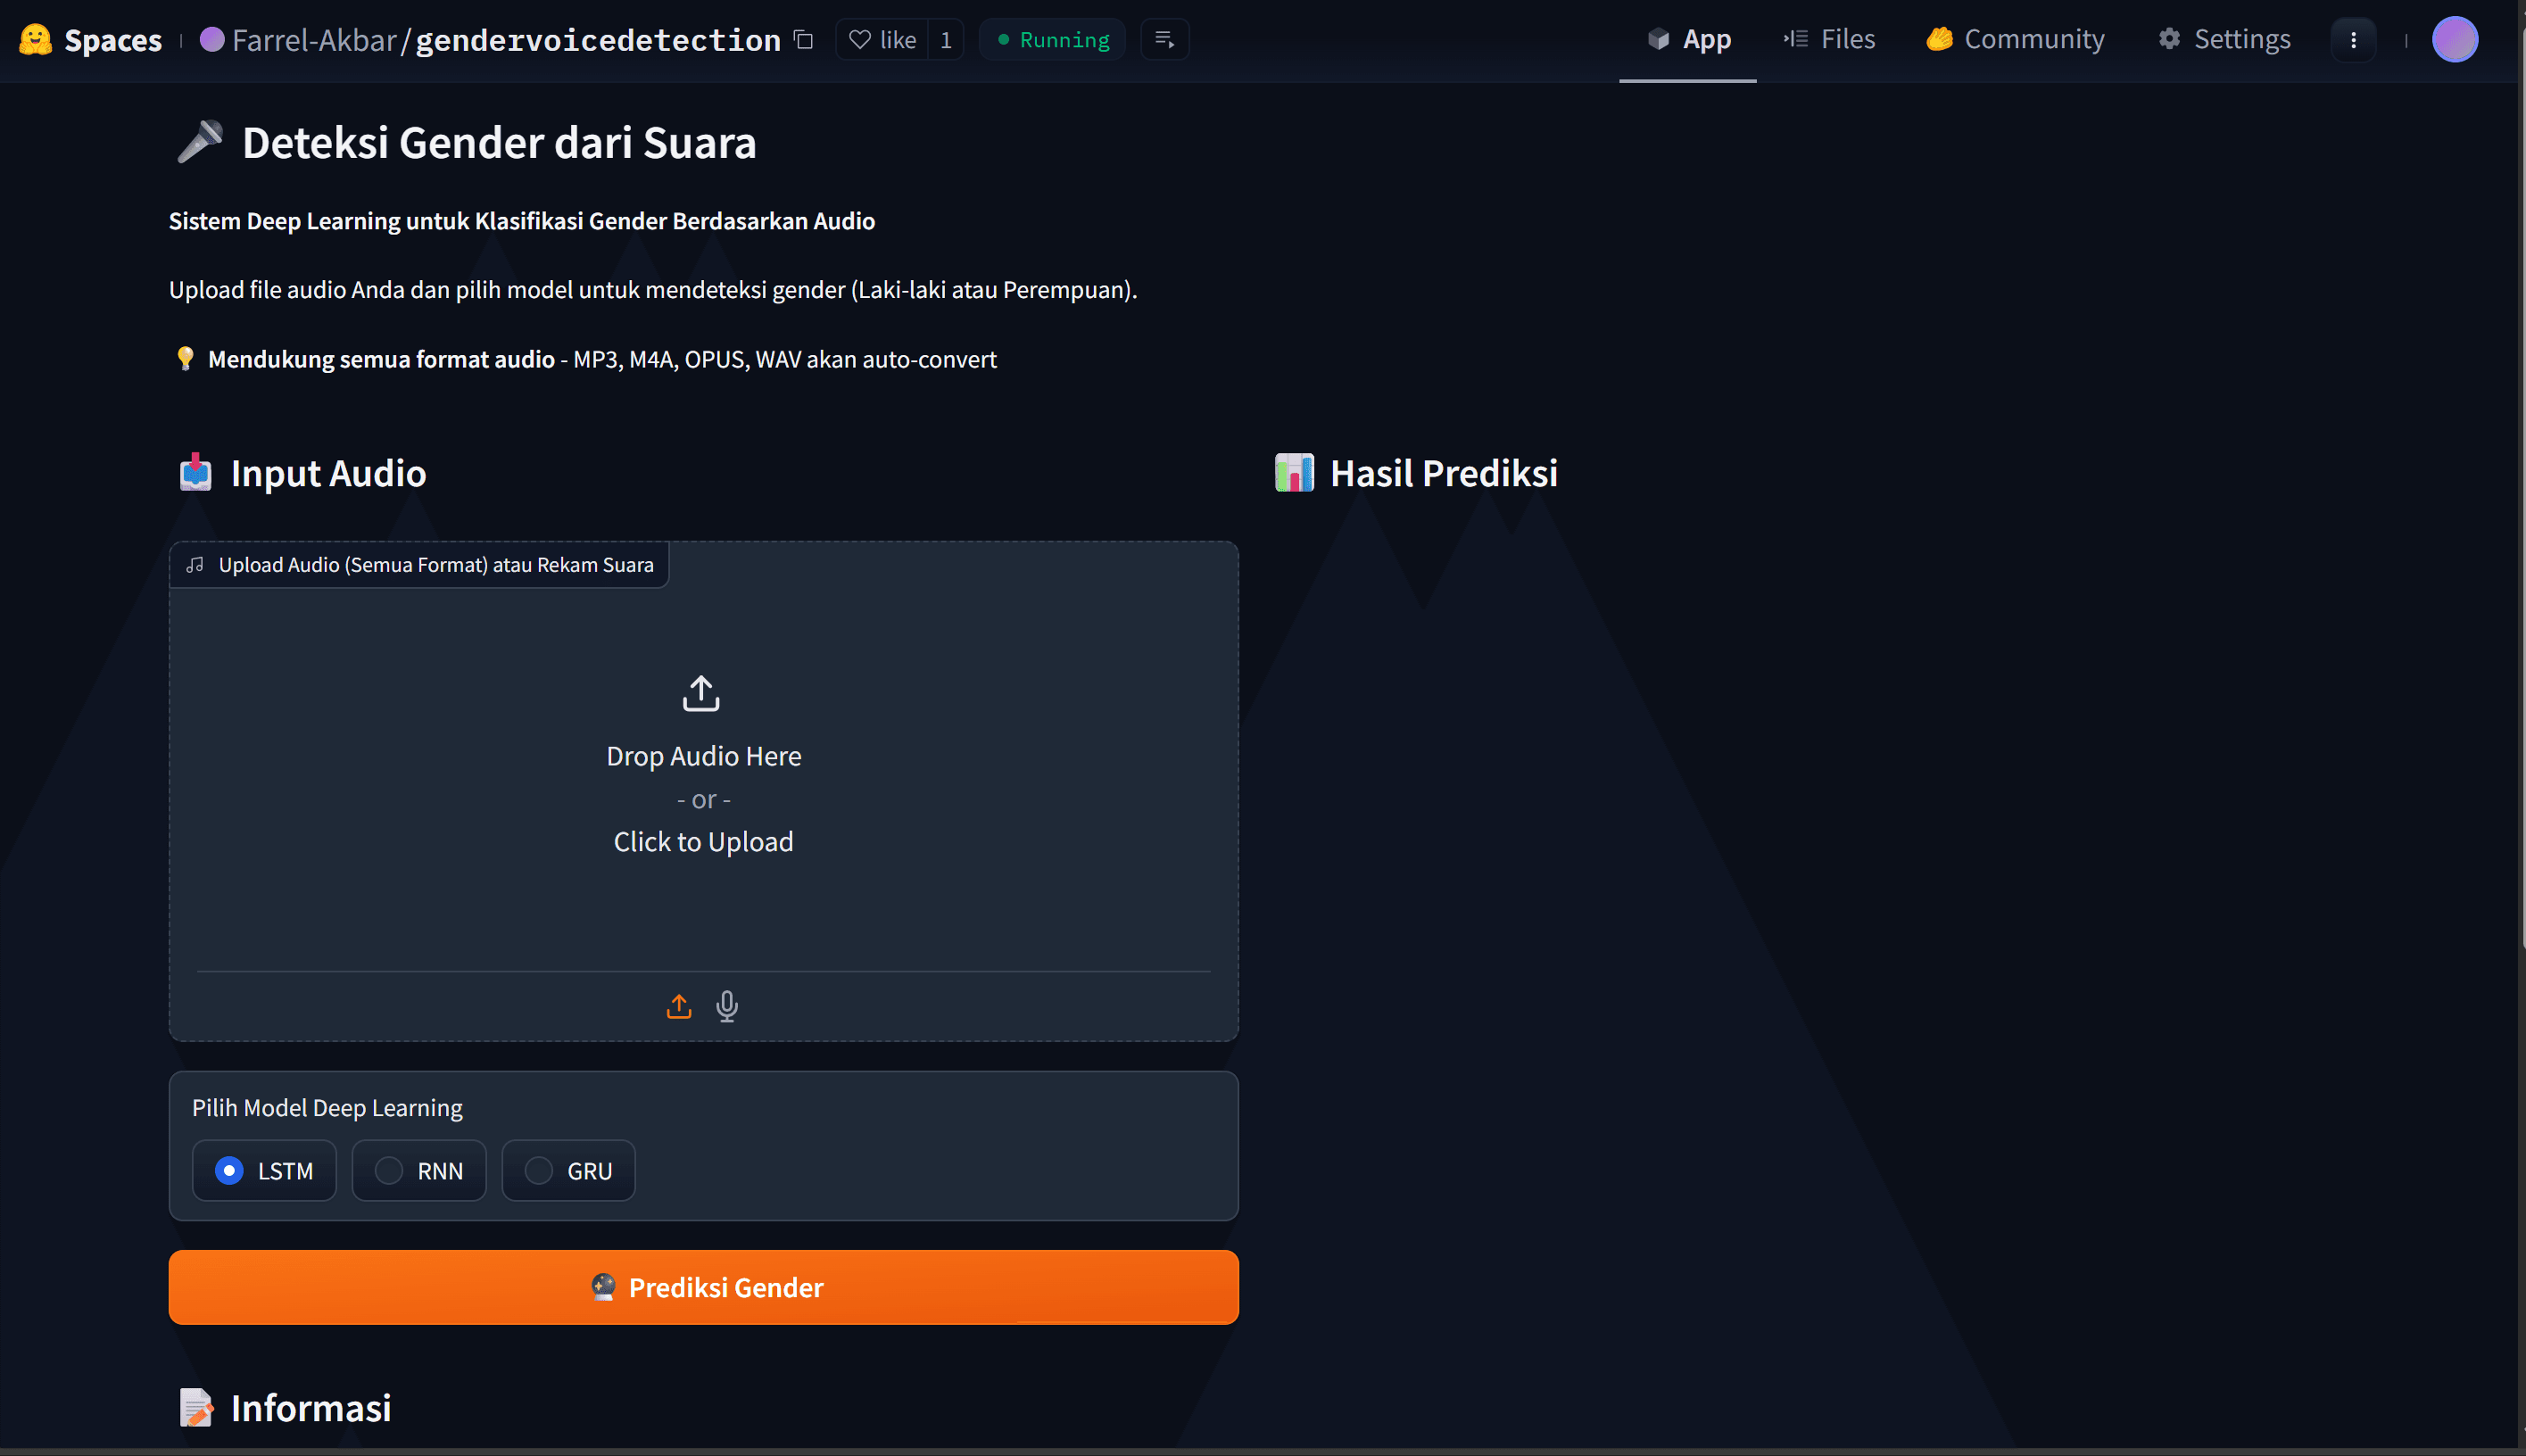
Gambar 1: Antarmuka Live di Hugging Face Spaces: Pengguna dapat mengunggah file audio (MP3, WAV, M4A) atau merekam suara langsung, memilih model, dan memperoleh hasil prediksi secara instan.
Mengapa Sistem Ini Perlu Dibangun?
Sering kali model machine learning audio berhenti pada notebook eksperimen tanpa pipeline deployment yang reproducible, version control data yang jelas, atau antarmuka yang dapat diuji langsung oleh pengguna umum.
Pengembang sistem biometrik suara, peneliti audio processing, dan pengguna interaktif.
Bagaimana Masalah Tersebut Diselesaikan?
Membangun sistem terstruktur: pemrosesan audio mentah menjadi MFCC (Mel-frequency cepstral coefficients), pelatihan arsitektur RNN/LSTM/GRU di TensorFlow/Keras, pelacakan metrik eksperimen dengan MLflow, pengelolaan versi dataset dengan DVC, serta kontainerisasi FastAPI/Gradio yang di-deploy otomatis via GitHub Actions ke Hugging Face Spaces.
Apa yang Secara Spesifik Dikerjakan?
Mengekstraksi fitur spektral audio menggunakan Librosa dan menyusun pipeline augmentasi data suara.
Melatih dan membandingkan performa arsitektur RNN, LSTM, dan GRU untuk klasifikasi biner suara pria/wanita.
Mengintegrasikan pelacakan metrik dan artefak model menggunakan MLflow dan DVC.
Membangun antarmuka web interaktif dengan Gradio/FastAPI serta mengonfigurasi deployment Docker di Hugging Face Spaces.
Teknologi & Peran Fungsionalnya
Bukan sekadar daftar nama tools, melainkan alasan mengapa teknologi tersebut dipakai dalam proyek ini.
TensorFlow & Keras
Arsitektur Deep Learning (RNN, LSTM, GRU) untuk klasifikasi sequence audio
Librosa
Ekstraksi fitur audio: MFCC, Chroma, dan Spectral Contrast
MLflow & DVC
Version control data, model artifacts, dan experiment tracking
FastAPI & Gradio
Backend inference dan antarmuka web interaktif pengguna
Hugging Face Spaces & Docker
Cloud hosting dan kontainerisasi aplikasi produksi
Keterbatasan Sistem & Pembelajaran Teknis
Refleksi objektif mengenai batasan desain eksperimen dan peluang pengembangan selanjutnya.
- •Performa model sangat dipengaruhi oleh tingkat kebisingan latar belakang (background noise) dan kualitas mikrofon pengirim.
Ingin Mendiskusikan Proyek Ini?
Saya siap menjelaskan metodologi, desain data, dan kode secara lebih terperinci.